
국내·미국 지수 예측 개발기: 미국 데이터와 뉴스를 넣고, 실제 성능을 확인하기
KOSPI·KOSDAQ의 다음 거래 세션을 예측하는 프로젝트에 미국 시장 입력, S&P 500·Nasdaq Composite 전망, 국제 뉴스 수집을 연결했습니다. 상승 확률과 예상 수익률을 계산하고, 그 결과를 과거 평가값·데이터 시각·검증 기준과 함께 보여주는 연구 도구입니다.
현재 네 지수의 모델은 모두 검증 기준 미달(rejected) 상태입니다. Production 가중치는 0이고, 뉴스의 수익률 혼합계수도 0입니다. 이 글에서는 개발 목적과 구현 방법, 실제로 측정한 성능, 그리고 평가 과정에서 확인한 한계를 정리합니다.
만들고 싶었던 도구
프로젝트의 출발점은 한국 시장 전체의 다음 세션 움직임을 확률과 가격 범위로 표현하는 것이었습니다. 여기에 미국 시장의 움직임과 국제 뉴스가 추가 정보를 주는지 확인하고 싶었습니다.
이를 위해 다음 항목을 한 화면에서 확인하도록 구성했습니다.
- 어느 지수를 어느 세션까지 예측하는가
- 현재 선택한 모델과 실제 사용한 입력은 무엇인가
- 상승 확률, 예상 수익률, 가격 범위는 얼마인가
- 과거 평가에서 기준 모델보다 나았는가
- 입력의 관측 시각과 누락, 검증에 실패한 이유는 무엇인가
입력을 늘리는 과정에서는 시각을 먼저 구분해야 했습니다. 미국 금요일 종가는 한국 토요일에 알 수 있는 정보입니다. 한국 월요일 예측에는 사용할 수 있지만, 아직 끝나지 않은 미국 월요일의 결과를 먼저 넣어서는 안 됩니다. 뒤늦게 수정된 가격이나 나중에 수집한 기사를 과거에도 알고 있었던 것처럼 사용하는 문제도 점검했습니다.
모델과 실제 사용한 입력
기본 가격 입력은 각 지수의 1·5·20세션 수익률, 5·20세션 변동성, 5·20세션 이동평균과의 괴리율 등 7개입니다.
선형 계열은 Ridge로 수익률을, Logistic Regression으로 상승 여부의 확률을 추정합니다. 비선형 후보는 LightGBM이며, 두 계열을 같은 비중으로 결합한 앙상블도 비교합니다. 수익률 예측과 상승 확률은 별도 출력이므로 두 값의 방향이 항상 같지는 않습니다.
한국 지수의 price_us 후보에는 다음 여섯 입력을 추가했습니다. 이 목록은 새 최종 평가값을 확인하기 전에 고정했습니다.
- S&P 500의 1세션 수익률
- Nasdaq Composite의 1세션 수익률
- SOX의 1세션 수익률
- VIX 수준
- VIX의 1세션 수익률
- SOX 수익률에서 Nasdaq 수익률을 뺀 값
price와 price_us는 같은 학습·평가 날짜에서 비교했습니다. 별도의 선형 price_us challenger도 미리 정했지만, 최종 구간에서 더 좋아 보인다는 이유로 주모델을 바꾸지는 않았습니다.
| 대상 | 이번 결과에 선택된 모델·입력 |
|---|---|
| KOSPI | 앙상블 / price_us |
| KOSDAQ | 선형 / price |
| S&P 500 | 선형 / 자체 가격 입력 |
| Nasdaq Composite | 선형 / 자체 가격 입력 |
따라서 이번 한국 주모델 중 미국 입력을 실제 사용한 것은 KOSPI입니다. KOSDAQ은 미국 입력 후보를 비교한 뒤에도 가격 입력을 유지했습니다. 미국 두 지수의 예측은 각자의 가격 이력·라벨·보정 결과로 계산했습니다.
한국 상위 보통주 100개·50개를 활용하는 breadth 입력과 외국인·기관·연기금 데이터 연결 규격도 만들었습니다. 다만 과거 시점의 구성원과 실제 수급 이력을 충분히 검증하지 못해 이번 수치에서는 제외했습니다. 구성원 목록을 오늘 기준으로 과거에 채워 넣지는 않았습니다.
시간순 검증과 발행 방식
검증은 expanding walk-forward 방식으로 진행했습니다. 초기 예측 시작 기준은 504세션, purge는 1세션, 재학습 간격은 21세션으로 설정했습니다. 매 시점에 사용할 수 있는 과거의 성숙한 라벨만 학습에 넣었습니다.
확률 보정과 가격 범위 계산에는 walk-forward에서 각 과거 시점의 학습 범위를 제한해 계산한 OOF(out-of-fold) 예측을 사용합니다. 이 OOF는 과거 재현 평가에서 계산한 값이며, 당시 실시간으로 발행한 기록과 구분합니다. 보정에는 최근 최대 252개, 최소 60개의 성숙한 예측 기록이 필요합니다. 가격 범위는 이 OOF 절대오차의 분위수를 이용한 명목 80% 구간입니다. 시계열에서 항상 80%를 보장하는 구간이라는 뜻은 아닙니다.
후보 선택용 development 구간과 최종 terminal 구간은 각각 252개 관측값으로 구분했습니다. 모델 선택은 development에서 하고, 선택을 고정한 후 terminal 기준을 확인합니다. 비교에는 20개 관측값 단위 블록을 재표집하는 paired bootstrap을 2,000회 사용했습니다.
이번 미국 입력 추가 실험의 terminal 이력은 이미 살펴본 자료입니다. 절차상 선택 구간을 분리했더라도, 이번 결과를 처음 보는 독립 데이터에서 얻은 성능이라고 주장하지 않습니다. 뒤에서 소개하는 미국 입력 비교도 retrospective 결과입니다.
미국과 한국은 서로 다른 거래소 달력과 시계를 사용합니다. 미국 주가지수의 통상 마감은 16:00 ET, VIX 정규 세션은 16:15 ET로 구분했습니다. VIX의 특수 단축장 마감이 별도로 검증되지 않은 경우에는 16:15 ET를 보수적 상한 가정으로 사용했으며, 이를 검증된 실제 단축장 마감시각으로 표현하지 않았습니다.
가격 제공자의 원래 공개 시각과 전체 수정 이력은 확인하지 못했습니다. 캘린더의 마감시각으로 재구성한 과거 가용성은 retrospective 가정으로 표시하고, 실제 수집·first-seen 시각을 과거로 바꾸지 않았습니다.
발행 결과는 receipt와 payload checksum을 함께 확인합니다. 큰 출력을 준비한 뒤 발행 시각을 점검하고, 유효한 receipt와 일치하는 결과만 발행된 전망으로 읽습니다. 이 시각은 선언된 publication-decision 기준이며, 운영체제에서 보이는 순간을 나노초 단위로 보장한다는 의미는 아닙니다.
먼저 밝혀야 할 평가 범위
한국 지수의 아래 정확도는 연속된 전체 거래일을 빠짐없이 평가한 값이 아닙니다.
한국 두 지수의 평가 대상일 범위는 2025-08-07부터 2026-10-23까지입니다. 달력을 대조하는 과정에서 이번 실행의 exchange-calendars XKRX 4.13.2가 2026년 6월 3일과 7월 17일을 열린 세션으로 포함한 문제를 확인했습니다. 두 날짜는 각각 지방선거일과 제헌절 휴장일입니다.
직접 확인한 KRX KIND 공지는 코넥스시장 휴장 안내이며, 유가증권시장 휴장 안내는 매일경제 전재본에서 같은 날짜를 확인했습니다. 전자를 KOSPI 직접 공지로, 후자를 원문 KRX 링크로 바꾸어 표기하지 않았습니다.
확인된 두 휴장일을 반영하면 이 구간의 비교 기준은 294세션입니다. 저장된 종가 날짜도 294개지만, 최종 평가 기록은 252개입니다. 실제 거래 세션 중 42개가 평가에 포함되지 않았습니다. 휴장일에 종가가 없는 것은 정상이며, 이를 원시 가격 데이터 장애로 분류하지 않았습니다.
가격이 있는데도 평가값이 없는 날짜는 2026-06-04~07-02와 2026-07-20~08-18에 각각 21개씩 있습니다. 세션 재정렬 뒤 전체 rolling window가 필요하다는 코드와 이 구간은 맞물립니다. 다만 archive에 행별 제외 사유가 없어, 모든 행의 원인이 직접 감사됐다고 단정하지는 않습니다.
이 글에서는 발행된 엔진을 수정하거나 백테스트를 다시 실행하지 않았습니다. 아래 값은 그 실행에서 평가된 252개 표본의 결과이며, 휴장일 처리를 수정한 새 성능도 전체 294세션의 정확도도 아닙니다.
반면 미국 두 지수의 terminal 대상일 범위는 2025-10-23부터 2026-10-23까지이며, 해당 XNYS 252세션에 평가값이 있습니다. 한국과 미국의 평가 범위가 다르므로 표의 숫자만으로 시장 자체의 예측 난이도를 비교하지 않았습니다.
실제 방향 적중률과 수익률 오차
저장된 direction_hit은 다음 규칙으로 계산합니다.
(예상 수익률 > 0) == (실제 수익률 > 0)
즉, 예상 수익률과 실제 수익률의 0 초과 여부가 같았는지를 셉니다. MAE는 예상 수익률과 실제 수익률의 평균 절대 차이이며, 아래 단위는 %p입니다.
| 지수 | 수익률 방향 적중 | 적중률 | 수익률 MAE | 명목 80% 구간의 실제 커버리지 |
|---|---|---|---|---|
| KOSPI | 173 / 252 | 68.651% | 1.7703%p | 62.70% |
| KOSDAQ | 117 / 252 | 46.429% | 1.7609%p | 67.06% |
| S&P 500 | 114 / 252 | 45.238% | 0.6395%p | 81.75% |
| Nasdaq Composite | 117 / 252 | 46.429% | 0.9307%p | 78.17% |
예를 들어 KOSPI의 68.651%는 이 252개 평가 표본에서 예상 수익률 방향이 맞은 비율입니다. 다음 세션의 상승 확률이 68.651%라는 뜻도, 실거래 승률이나 수익률이라는 뜻도 아닙니다. 특히 한국 결과에는 위에서 밝힌 평가 제외 구간이 있습니다.
상승 확률도 기준 모델과 비교했다
화면의 p_up은 앞으로 수익률이 0보다 클 확률의 추정치입니다. 이것을 0.5에서 나눈 분류 적중률은 앞의 수익률 방향 적중률과 별개입니다.
| 지수 | p_up ≥ 0.5 분류 적중 | 과거 상승빈도 기준 분류 적중 | 모델 Brier | 상승빈도 기준 Brier |
|---|---|---|---|---|
| KOSPI | 172 / 252 (68.254%) | 158 / 252 (62.698%) | 0.216225 | 0.240517 |
| KOSDAQ | 138 / 252 (54.762%) | 138 / 252 (54.762%) | 0.252973 | 0.247897 |
| S&P 500 | 133 / 252 (52.778%) | 133 / 252 (52.778%) | 0.252282 | 0.249727 |
| Nasdaq Composite | 134 / 252 (53.175%) | 134 / 252 (53.175%) | 0.252582 | 0.249765 |
Brier는 확률 예측의 오차를 평가하는 점수로, 낮을수록 좋습니다. 0.216225를 ‘오차율 21.6%’나 ‘정확도 78.4%’로 바꾸면 안 됩니다. 분류 적중 횟수가 같아도 예측한 확률의 크기에 따라 Brier는 달라집니다.
KOSPI는 확률 지표가 개선됐지만 구간 커버리지가 62.70%로 75–85% 기준에 못 미쳤습니다. KOSDAQ도 구간·확률·하방 위험 등의 기준을 통과하지 못했습니다. 미국 두 지수는 커버리지가 기준 범위 안에 들어왔지만, development와 확률·log loss 등의 기준을 모두 통과한 것은 아닙니다. 최종 판정은 네 지수 모두 rejected입니다.
미국 입력은 어떤 차이를 만들었나
같은 가족·같은 252개 평가 날짜에서 price_us의 Brier에서 price의 Brier를 뺀 결과입니다. 음수이면 미국 입력 후보의 점수가 더 낮습니다.
| 비교 | Brier 차이 | paired bootstrap 95% 구간 |
|---|---|---|
| KOSPI 앙상블: price_us − price | −0.024757 | [−0.044680, −0.013119] |
| KOSDAQ 선형: price_us − price | −0.006610 | [−0.012553, +0.001304] |
이 표본에서 KOSPI 앙상블의 Brier 감소는 확인됩니다. KOSDAQ 구간은 0을 포함합니다. 이 비교에는 앞서 설명한 한국 평가 제외 구간과 retrospective 성격이 그대로 적용됩니다. 뉴스 가중치가 0이므로 이 개선을 뉴스의 효과로 설명하지 않았습니다.
다음 세션 전망과 실제 화면
다음 표는 과거 정확도가 아니라, 저장된 다음 세션 연구 전망입니다. 최신 지수 가격 봉의 기준일은 2026-10-23이고, 실제 수집·발행 시각은 별도로 기록했습니다. 한국 결과의 publication decision은 2026-10-24 00:46:32 UTC, 미국은 00:47:02 UTC입니다. replay는 아닙니다.
| 지수 | 상승 확률 | 예상 수익률 | 예상 종가 | 명목 80% 종가 범위 |
|---|---|---|---|---|
| KOSPI | 58.243% | +0.326651% | 5568.43 | 5414.76–5722.10 |
| KOSDAQ | 57.870% | +0.175818% | 753.01 | 733.90–772.12 |
| S&P 500 | 53.131% | +0.082679% | 7629.98 | 7551.13–7708.83 |
| Nasdaq Composite | 55.570% | −0.006845% | 25953.57 | 25549.96–26357.17 |
대상은 모두 현지 거래 세션 2026-10-26입니다. 한국 종가는 10월 26일 15:30 KST, 미국 종가는 10월 26일 16:00 EDT, 즉 한국시간 10월 27일 05:00입니다. 한국 두 결과는 주말 preliminary이며 월요일 premarket_final이 아닙니다. 발행 receipt가 유효하다는 사실과 최종 아침 전망이라는 단계는 구분합니다.
Nasdaq은 상승 확률이 50%를 넘지만 예상 수익률은 소폭 음수입니다. 확률과 수익률을 별도로 추정한 실제 출력이므로 부호를 임의로 바꾸지 않았습니다. 10월 26일의 실제 결과는 아직 없으며, 이 표로 적중 여부를 말할 수 없습니다.
아래 이미지는 저장된 결과를 로컬 브라우저에서 직접 연 화면입니다. 이미지 생성이나 합성으로 수치를 만든 화면이 아닙니다. 각 이미지를 누르면 원본 크기로 볼 수 있습니다.
KOSPI
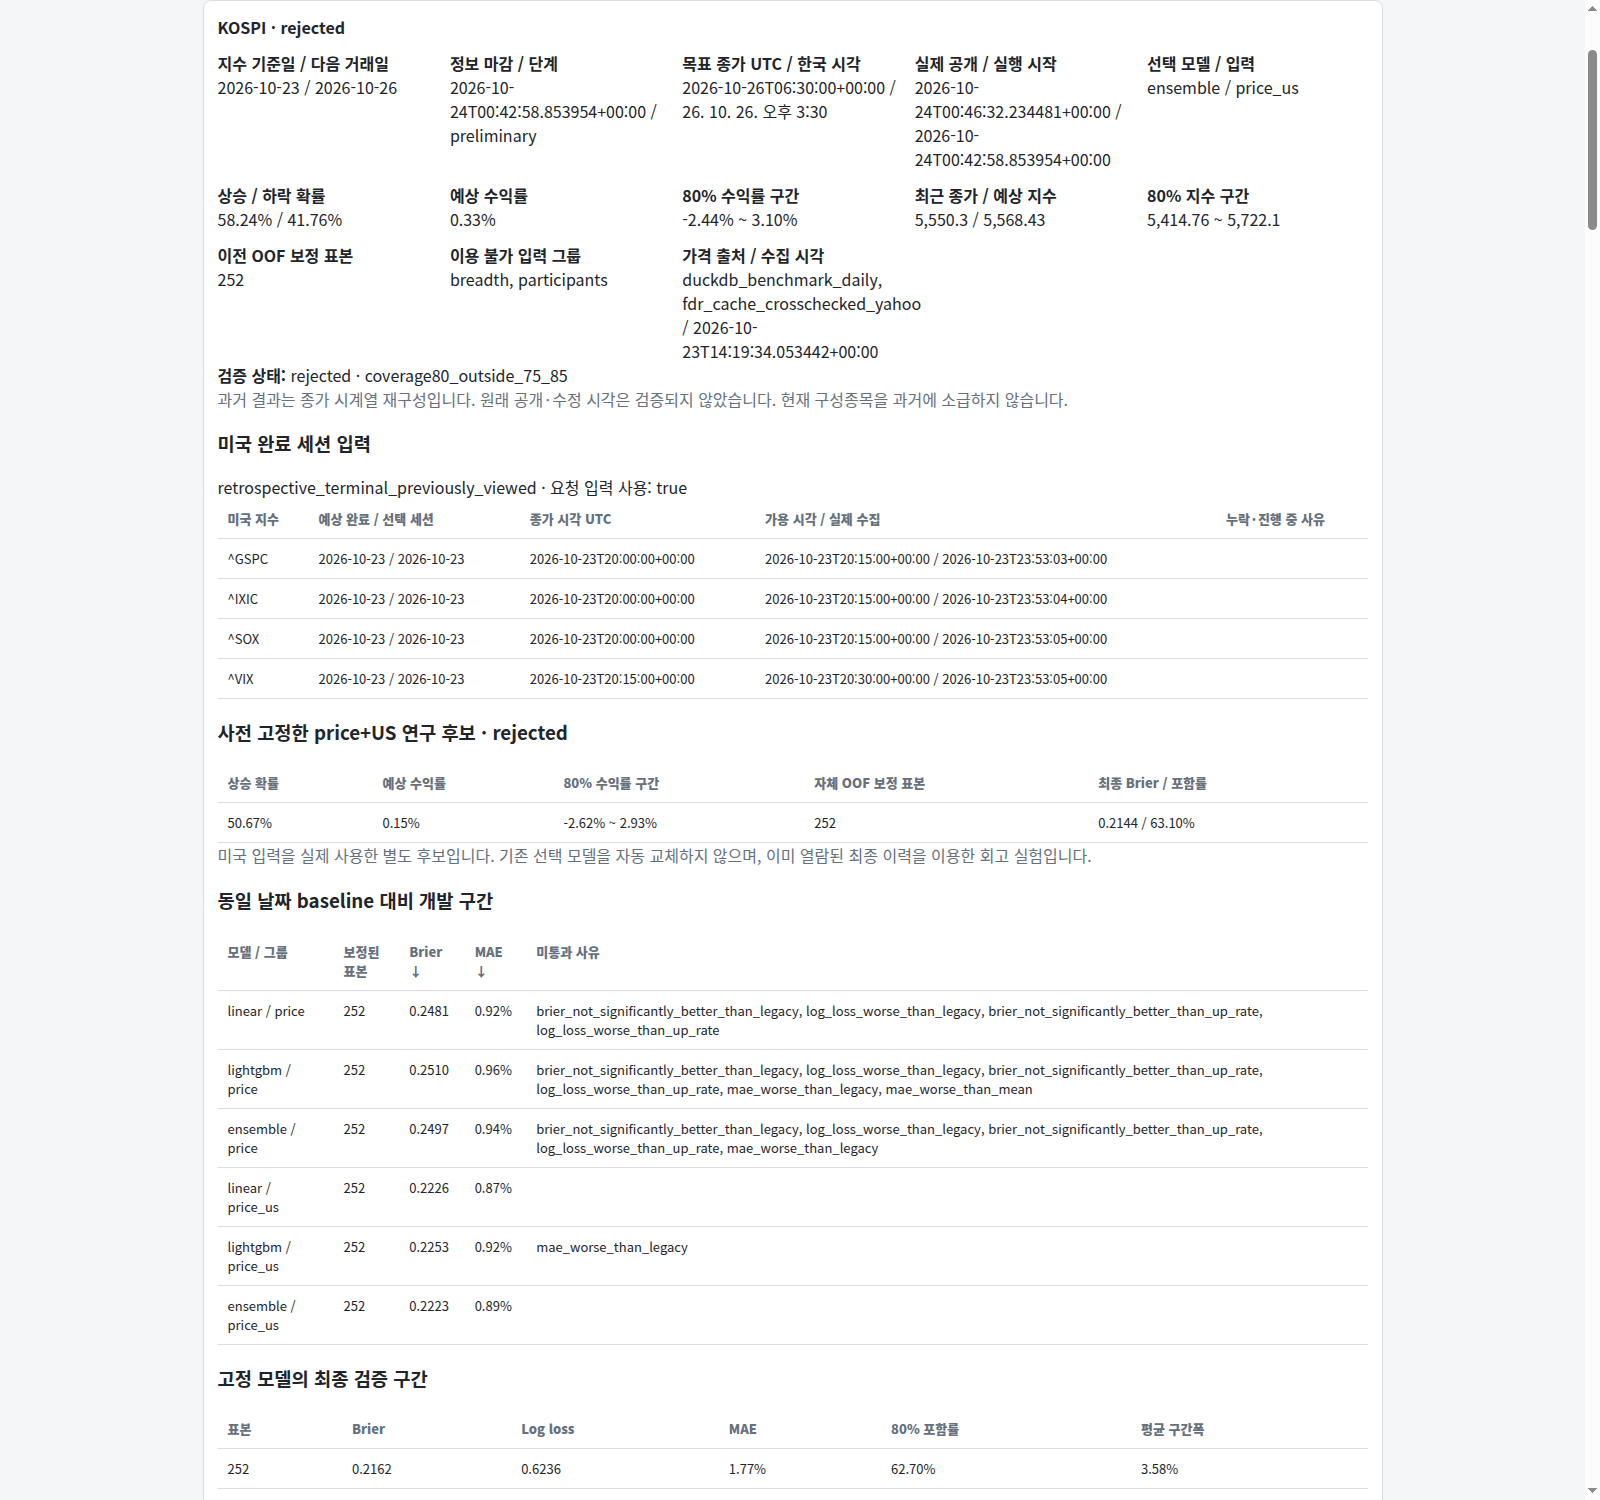
KOSPI 상세 화면입니다. 현재 전망, 선택된 미국 입력, 검증 기준 미달 상태가 함께 보입니다. 네 시장 전체를 한 번에 보여주는 캡처는 아닙니다.
KOSDAQ
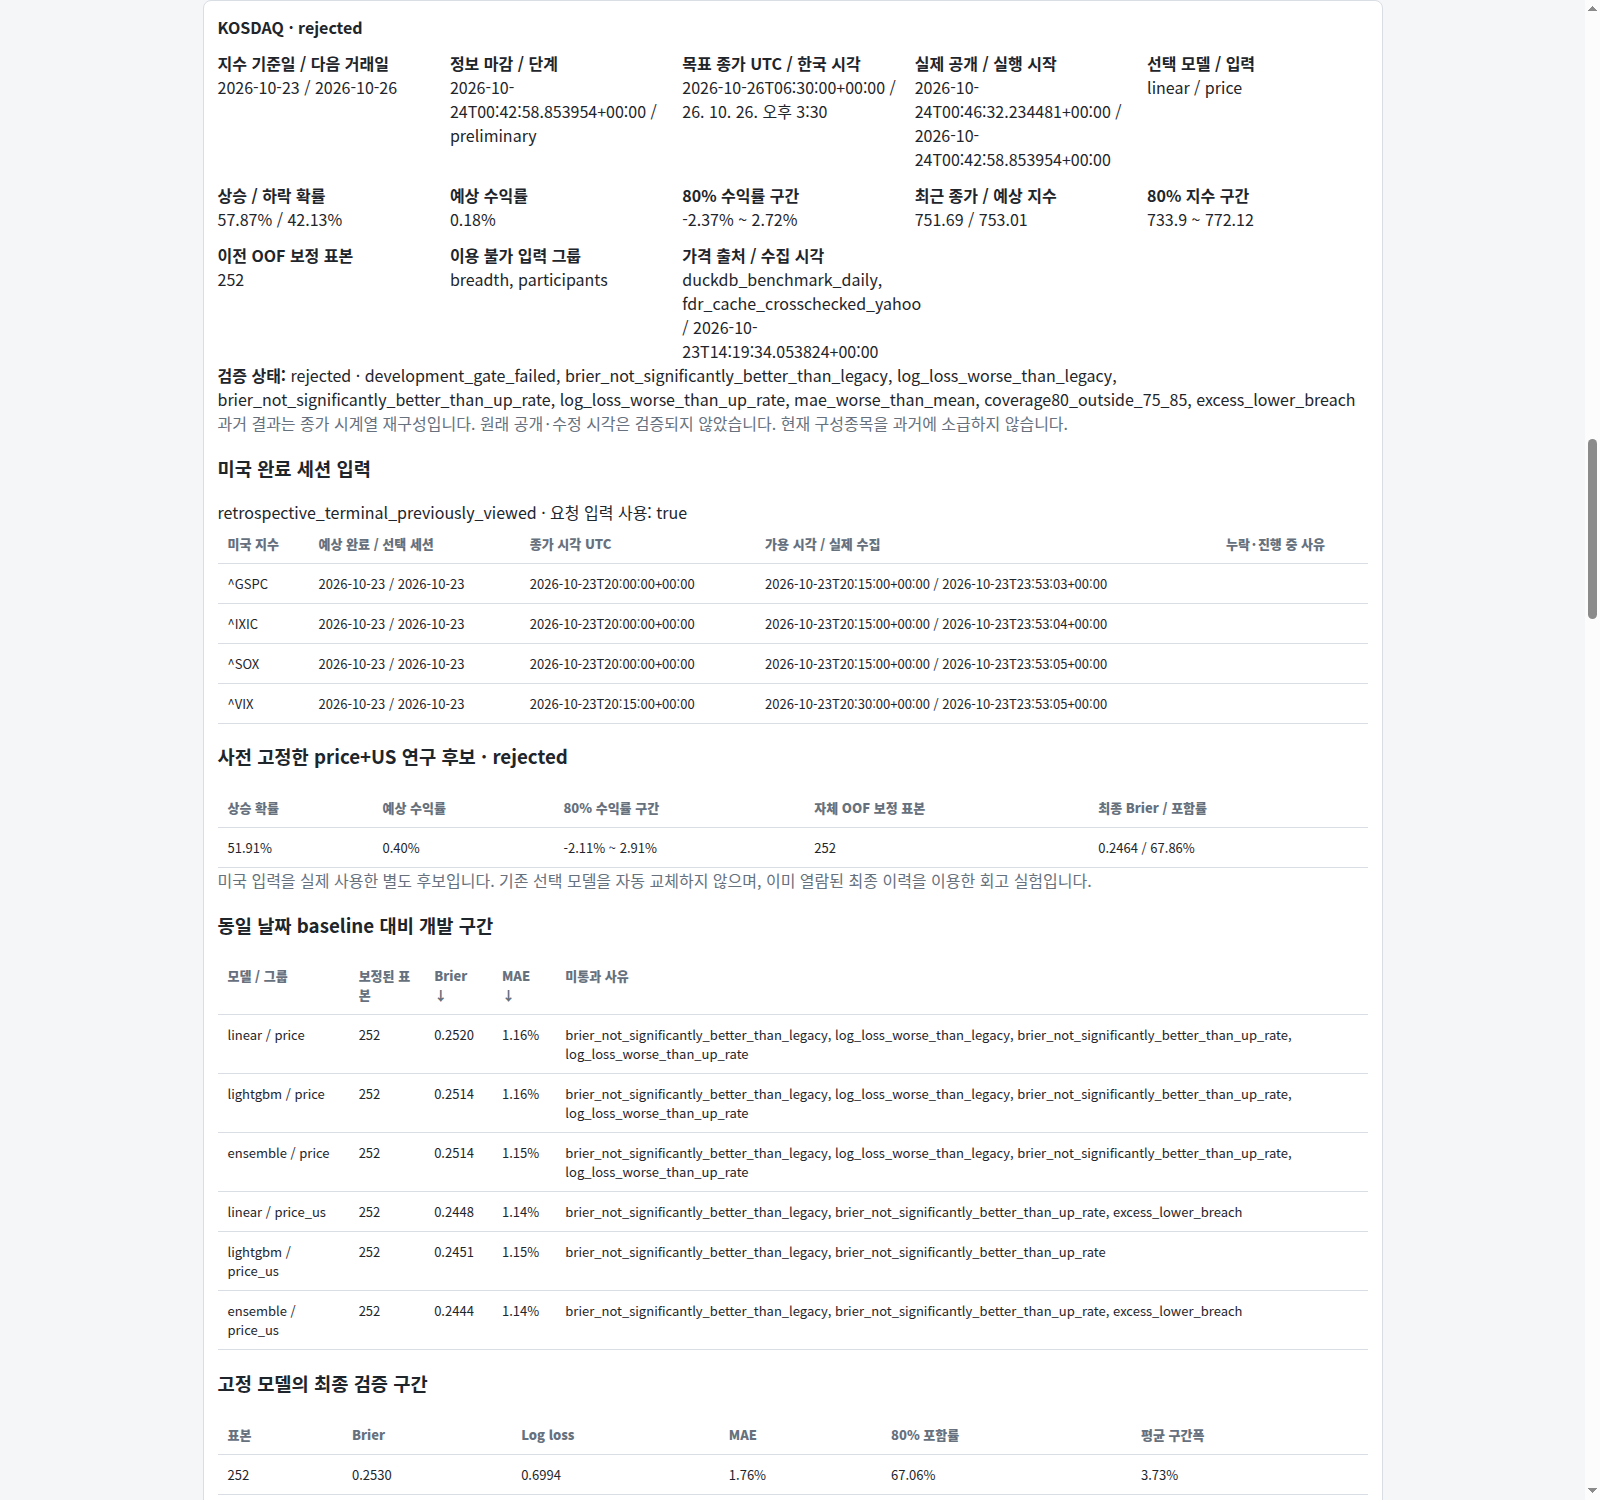
KOSDAQ 주모델은 가격 입력을 유지했습니다. 별도 미국 입력 challenger의 현재 상승 확률은 51.910%, 예상 종가는 754.71이지만, 검증 기준을 통과하지 못해 주모델로 승격하지 않았습니다.
S&P 500
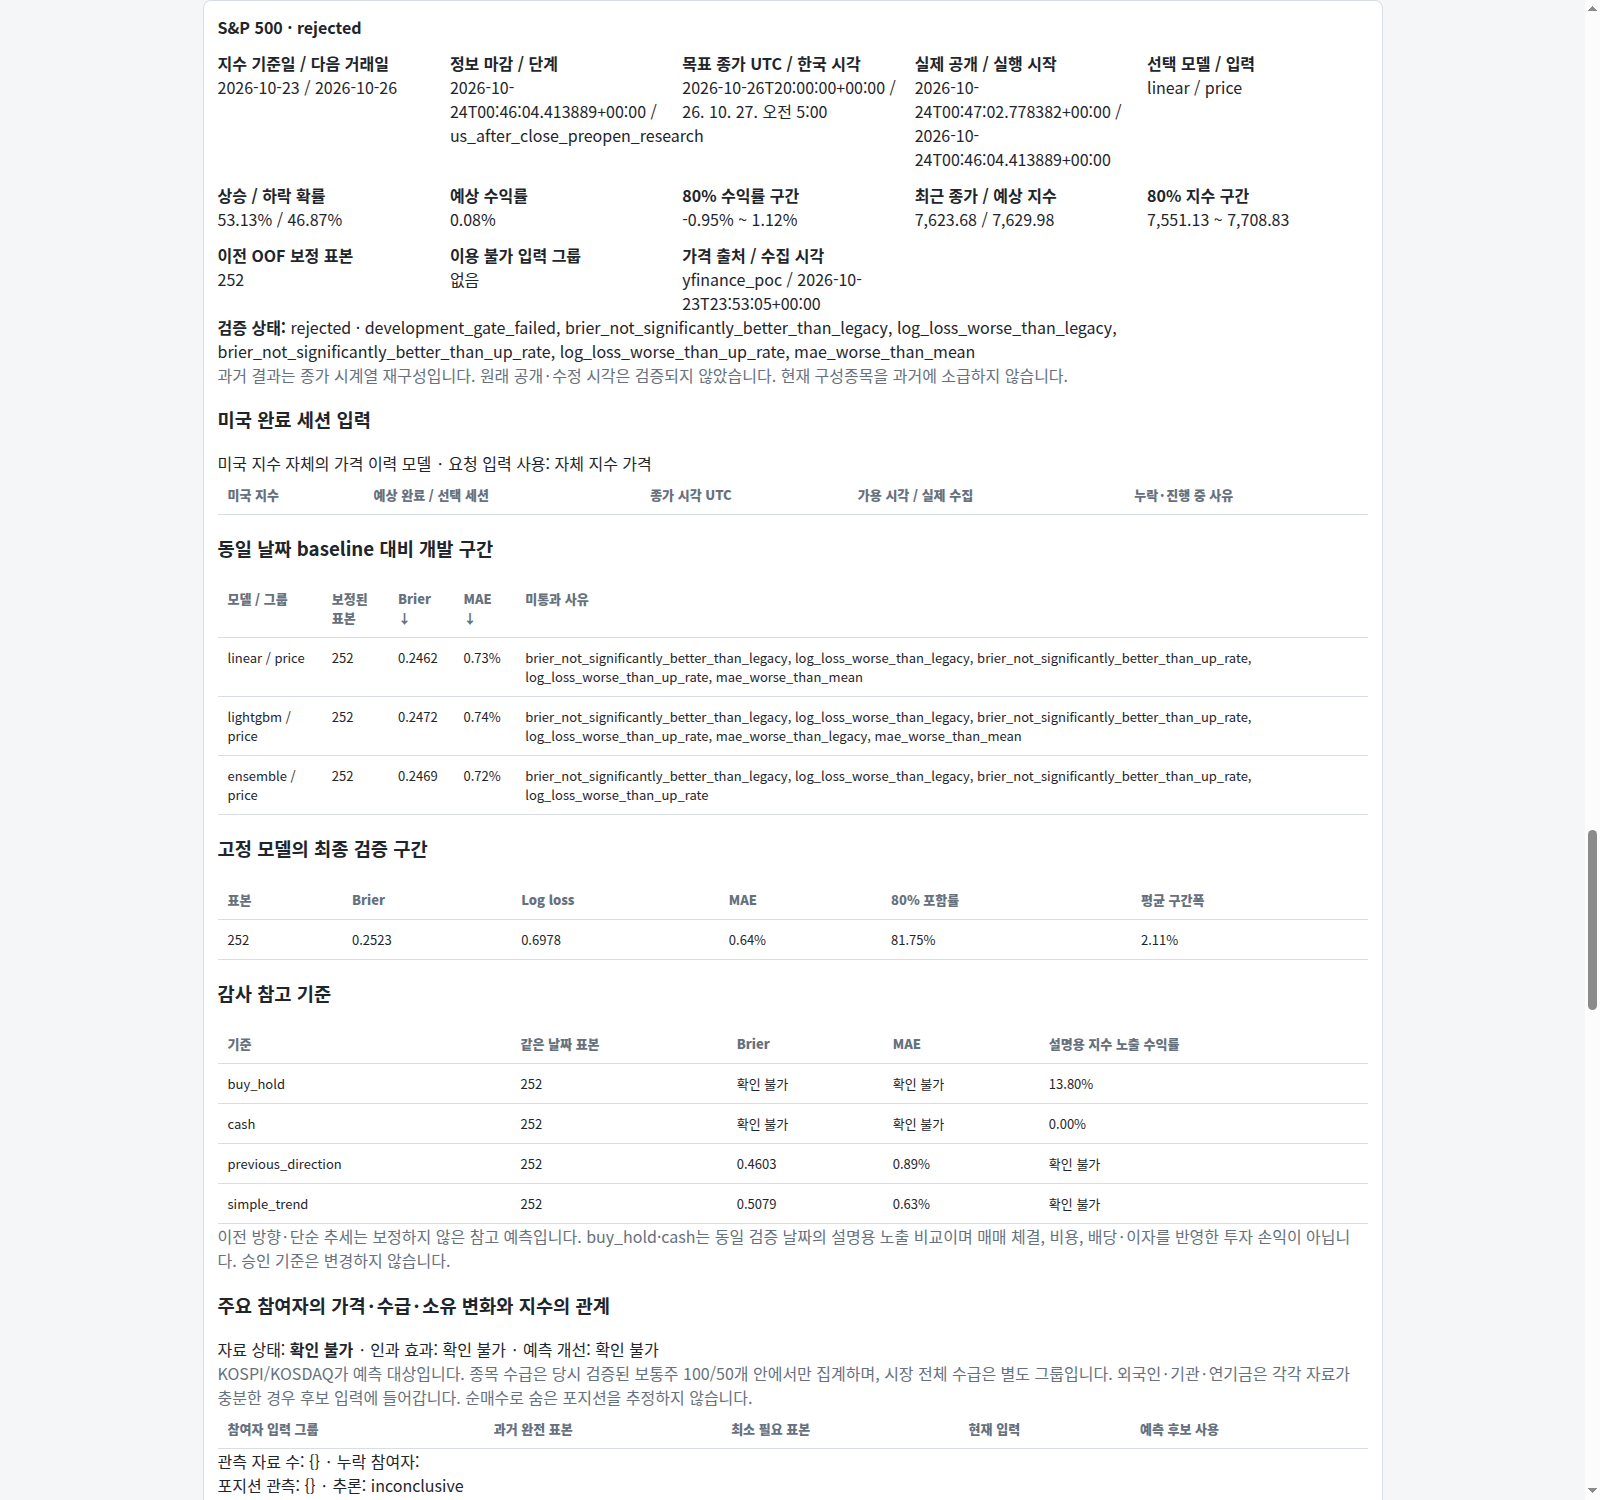
미국 지수는 한국의 발행 기한을 재사용하지 않고, XNYS 세션과 자체 가격·라벨을 사용합니다.
Nasdaq Composite
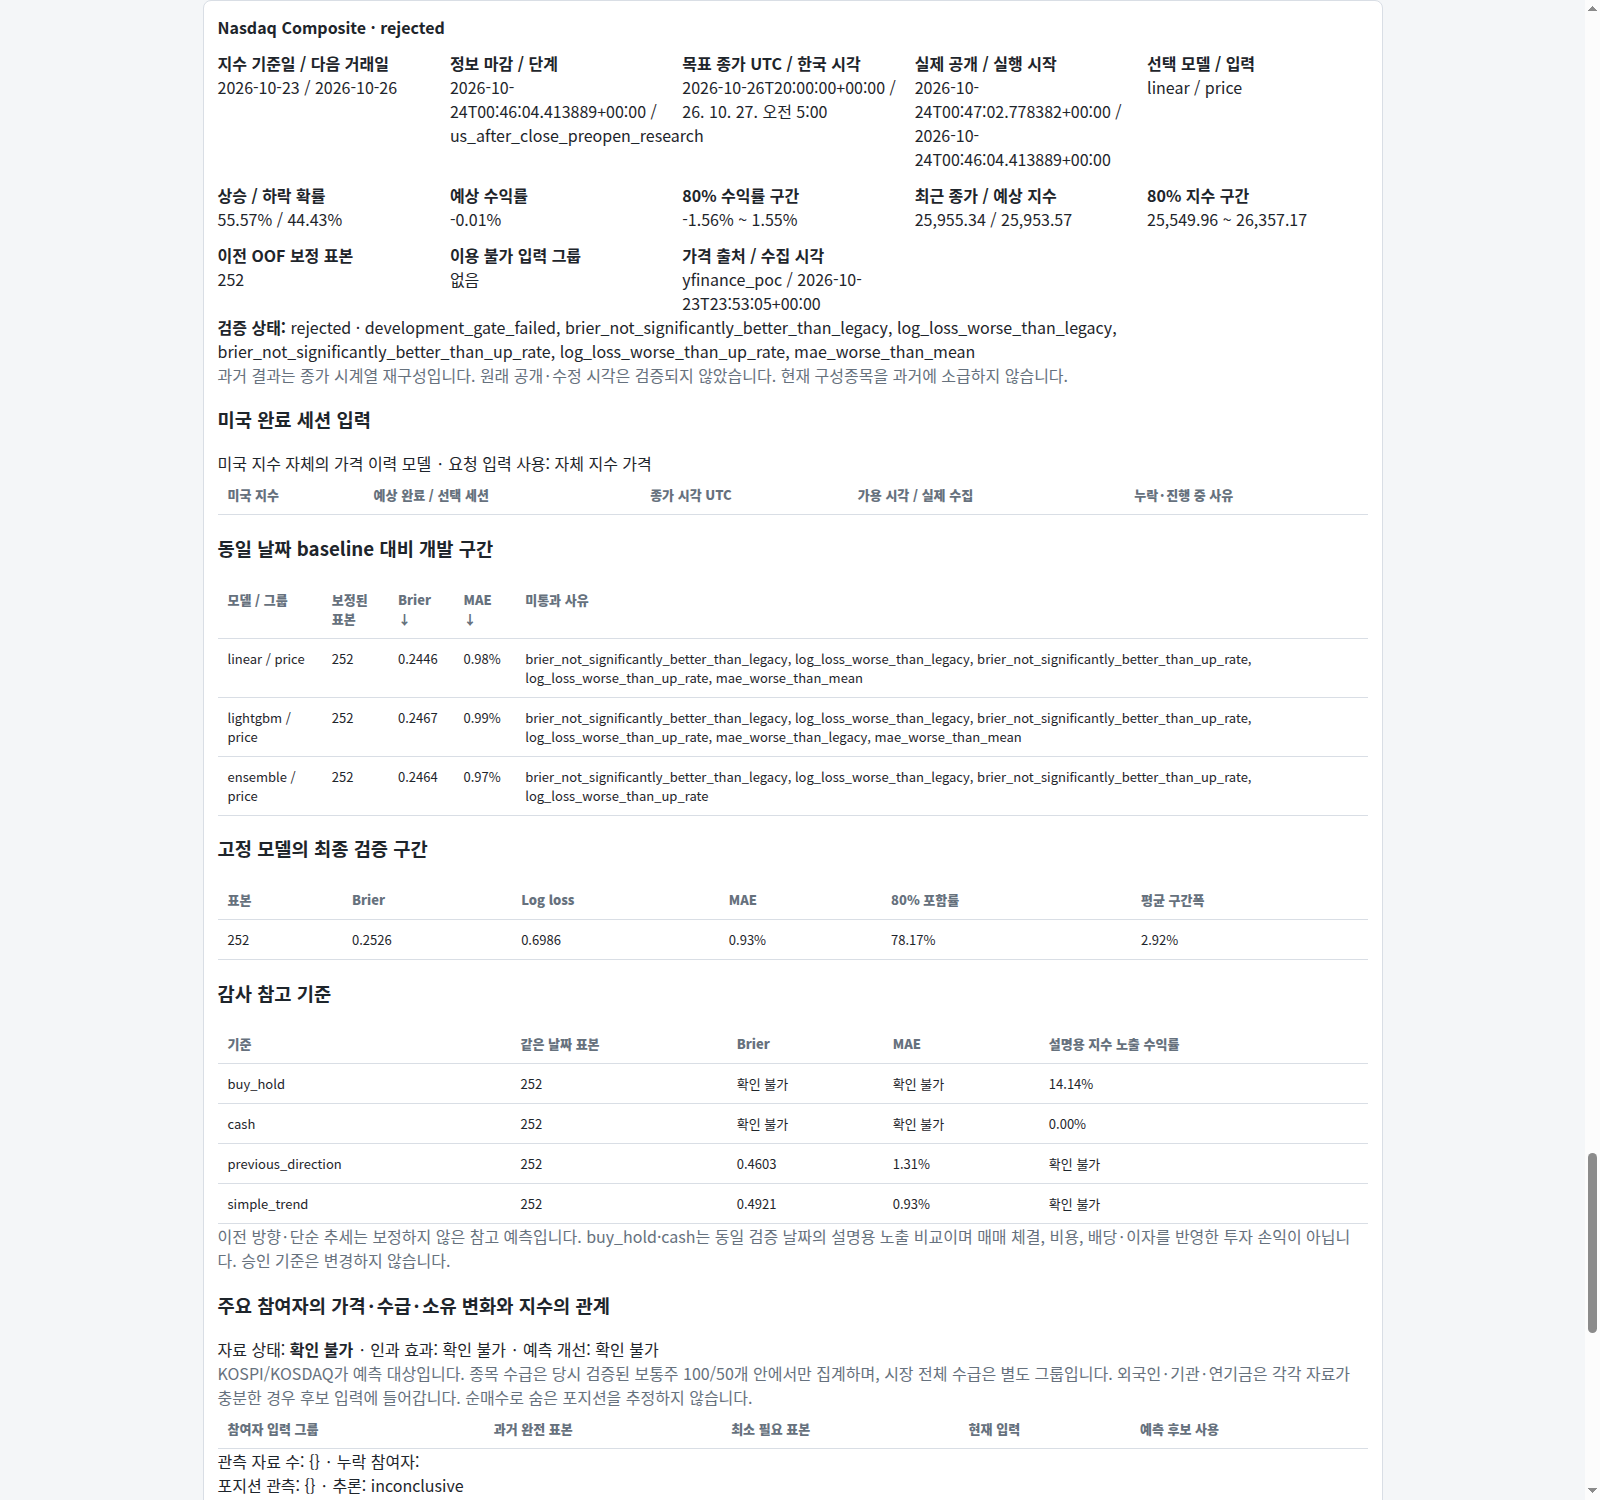
화면의 −0.01%는 표의 예상 수익률을 표시용으로 반올림한 값입니다.
국제 뉴스 가중치가 현재 0인 이유
뉴스는 출처, 공개·수정·first-seen 시각, 중복 여부와 주장 상태를 함께 기록합니다. 공식 발표가 있었다는 사실과 발표 내용이 독립적으로 확인됐다는 사실도 구분합니다.
현재 수집분은 Fed 20개, UN 30개, ECB 15개, 이란 관련 맥락 6개를 합친 71개 항목입니다. 모두 전쟁 기사나 서로 독립적인 사건이라는 뜻은 아닙니다. 기관의 이름만으로 금리정책 기사라고 분류하지 않고, 일반적인 RSS 항목을 자동으로 미확인 주장으로 취급하지 않도록 점검했습니다.
가중치는 두 종류로 나눴습니다.
- 출처·노후도 attention: 어느 자료를 얼마나 오래된 정보로 볼지 정하는 입력 처리 규칙입니다. 가격 영향의 방향을 뜻하지 않습니다.
- 수익률 혼합계수 α: 가격 모델과 뉴스 후보를 결합하는 계수입니다. 후보 0, 0.05, 0.10, 0.20을 고정하고, 충분한 과거 이력이 있을 때 development 결과로만 선택하도록 했습니다.
양의 α를 사용하려면 같은 날짜의 OOF 비교와 혼합 결과 자체의 확률·잔차 보정이 필요합니다. 현재는 완전한 PIT 수집 구간과 성숙한 뉴스 OOF 이력이 없어 네 지수 모두 α=0입니다. 저장된 결과에서 뉴스 혼합 전후의 전체 forecast dict가 정확히 같은 것도 확인했습니다. 기사 수가 늘었다는 이유만으로 가격 방향이나 확률을 임의로 바꾸지 않았습니다.
현재 보도는 위험 맥락으로 표시합니다. AP의 10월 22일 해운 보도는 이란 측 사건 주장을 독립적으로 확인하지 못했다고 설명합니다. AP의 10월 23일 보도와 Reuters의 10월 23일 신디케이션도 관련 발언의 출처이며, 그 발언을 실제 작전이나 통항량의 독립 확인으로 바꾸지 않았습니다.
당시의 제한된 확인에서는 새 10월 23일 직접 공격을 검증하지 못했습니다. 이는 공격이 없었다는 단정이 아닙니다. 확전, 해운 차질, 완화는 조건부 시나리오로 구분하고 수치 예측에 임의의 확률 가산점을 주지 않았습니다.
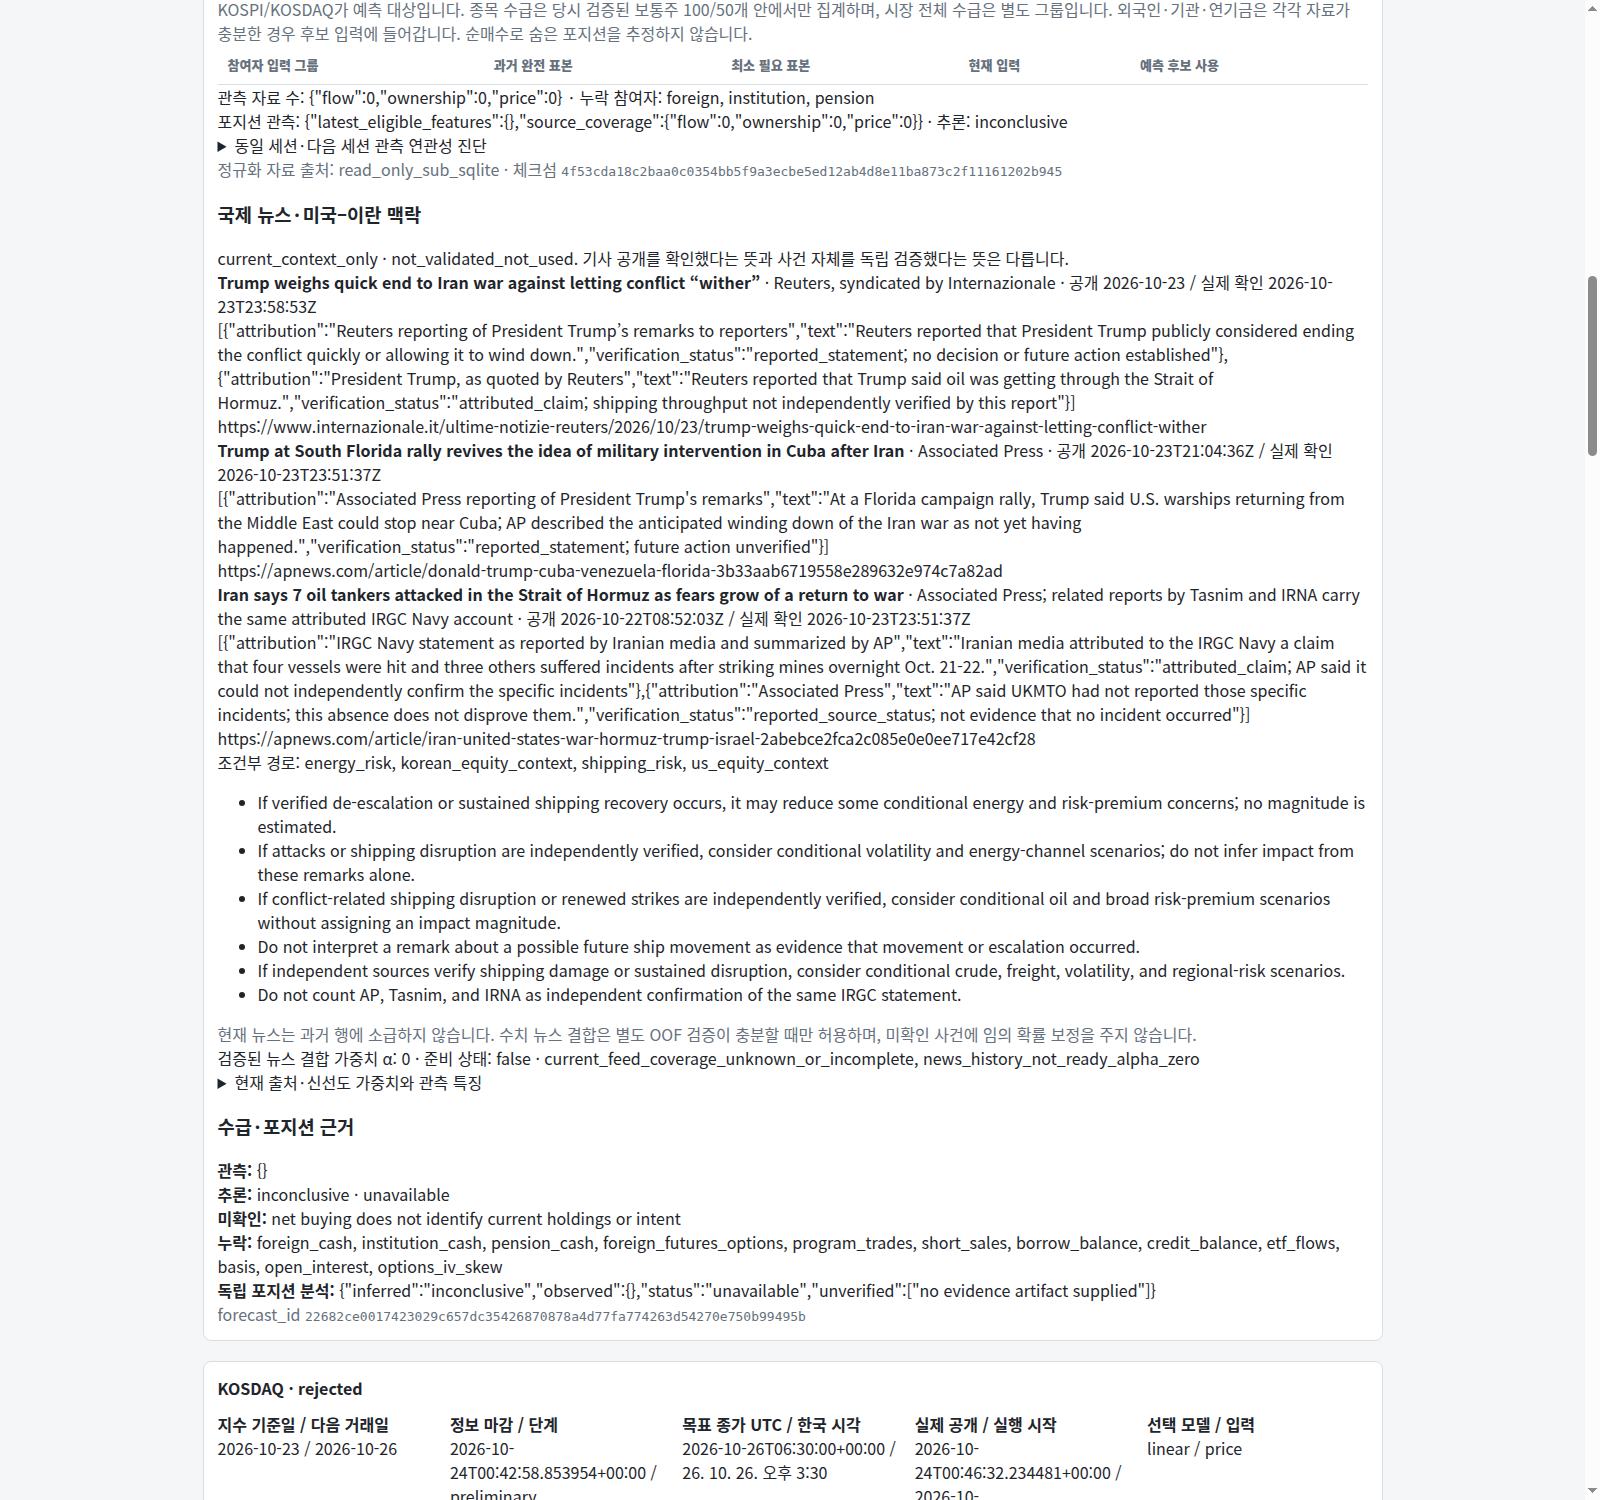
참여자 분석용 하위 프로젝트의 실제 가격·수급·보유 관측은 0건입니다. 그래서 외국인·기관·연기금의 보유 포지션과 지수 영향은 불확실하며, 가격 움직임만 보고 숨은 계좌나 헤지를 추정하지 않았습니다.
사용한 기술과 소프트웨어 검증
| 기술 | 사용한 역할 |
|---|---|
| Python 3.12, pandas, NumPy | 시계열 정렬, 특성 계산, 지표와 데이터 검사 |
| scikit-learn | Ridge·Logistic Regression과 확률 보정 |
| LightGBM | 얕은 트리 기반 회귀·분류 후보 |
| SQLite | 예측 입력 조회와 데이터 이력 연결 |
| exchange-calendars | 시장별 세션·시간대·마감시각 처리 |
| RSS 수집기·설정 파일 | 공개 피드 수집, 중복과 관측 버전·수집 시도 기록 |
| CLI, JSON, 정적 HTML | 재현 가능한 실행, 검증 보고서와 실제 화면 |
개발에는 소스 작성, 수집·실행, 독립 검토의 역할을 나눈 AI 에이전트도 사용했습니다. 이 역할 분리는 개발 도구에 관한 이야기입니다. 언어 모델이 위 지수 가격을 직접 답하거나, 언어 모델 때문에 정확도가 올랐다고 주장하는 구조는 아닙니다.
소스 커밋 329168d에 포함된 보고서에 기록된 과거 소프트웨어 검증 결과는 clean-tree pytest 369개 통과·1개 건너뜀, 미국 입력·통합·뉴스 범위의 strict 테스트 37개 통과, Smart Money 하위 프로젝트 테스트 10개 통과입니다. 변경 파일 Ruff와 수정 사항의 독립 검토도 기록돼 있습니다. 이는 이 블로그를 작성하며 새로 실행한 테스트 수가 아닙니다. 일반 전체 테스트에는 기존 경고 207개가 남아 있어 전역 warning-strict까지 통과했다고 표현하지 않았습니다.
다음 작업에서는 한국 평가 제외 구간과 캘린더를 먼저 확인하고, 행별 제외 사유를 남길 필요가 있습니다. 이어서 새로운 기간에서도 미국 입력의 효과가 유지되는지, 완전한 뉴스 수집 구간에서 양의 α가 기준 모델을 개선하는지, 실제 참여자 데이터가 추가 정보를 주는지를 검증하려고 합니다. 실제 final 관측 60일 요구도 아직 충족하지 못했습니다.
현재 상태는 화면과 실행이 검증된 연구 도구이며, 네 모델의 재무적 검증 기준은 미달입니다. 코드와 결과를 함께 남겨 이후 실험에서 무엇이 바뀌었는지 비교할 수 있도록 했습니다.